07 - 偏好对齐
SFT 之后的模型会对话了,但「会对话」和「答得好」是两回事。这一篇讲怎么让模型学会在多个都通顺的回答里挑更好的那个,产出 dpo.py。
前置:06 篇跑完的 SFT checkpoint。
零、开始之前:SFT 之后还缺什么
0.1 SFT 的天花板在哪
SFT 干的事是模仿:给一堆「问题 → 标准回答」,让模型学着照做。
这套办法有个天生的上限。模仿只能让模型逼近训练数据的水平,没法超过它。 而且模仿是无差别的,训练数据里写得好的和写得一般的,模型一视同仁地学。
更关键的是,SFT 只告诉模型「什么是对的」,从来没告诉它「什么是不好的」。模型不知道哪些回答该避免。
0.2 一个具体的例子
同一个问题,两个都通顺的回答:
问:帮我写一封请假邮件

回答 A:
好的,这是一封请假邮件:
尊敬的领导,我因身体不适需请假一天,望批准。此致敬礼。

回答 B:
好的,这是一封请假邮件:
主题:请假申请(3 月 5 日)
尊敬的张经理:
我因感冒发热需于 3 月 5 日请假一天,期间工作已交接给李明,
紧急事项可电话联系我。给您带来不便,敬请谅解。
                                        王强
                                     2026 年 3 月 4 日
两个都没错,语法都通,都是「请假邮件」。但 B 明显更好。
SFT 没法表达这种差别——它的数据里只有一个标准答案,没有「这两个之中 B 更好」这种信息。
偏好对齐要做的就是把这种比较信息喂给模型。
0.3 偏好数据长什么样
不再是「问题 + 答案」,而是「问题 + 更好的答案 + 更差的答案」:
{
  "prompt": [{"role": "user", "content": "帮我写一封请假邮件"}],
  "chosen": "主题:请假申请……(详细版)",
  "rejected": "尊敬的领导,我因身体不适需请假一天……(简略版)"
}
行业黑话叫 chosen 和 rejected,或者 (win)和 (lose)。
标注这种数据比标注 SFT 数据容易得多:让人从头写一个好回答很难,但让人在两个回答里选一个更好的,很快。这是偏好学习能规模化的原因。
0.4 三条路线
从偏好数据到对齐的模型,主流有三条路:
| 路线 | 一句话 | 出现时间 |
|---|---|---|
| PPO | 先训个奖励模型打分,再用强化学习去最大化分数 | 2022,ChatGPT 用的 |
| DPO | 数学上把 RL 消掉,变成一个监督学习问题 | 2023 |
| GRPO | 回到 RL,但去掉最重的那个部件 | 2024,DeepSeek 推广 |
这一篇以 DPO 为主(简单、稳、单卡跑得动),但会先讲 PPO,因为不理解 PPO 就理解不了 DPO 在消掉什么。最后讲 GRPO 为什么又转回 RL。
一、经典 RLHF:PPO 那条路
1.1 三个阶段
06 篇做完的是阶段一。
1.2 奖励模型
阶段二训一个奖励模型(reward model,RM)。它的输入是「问题 + 回答」,输出是一个标量分数。
训练方式是让它在偏好对上排序正确,loss 是:
含义很直白:让 chosen 的分数高于 rejected,差距越大 loss 越小。 是 sigmoid。
记住这个式子的形状,DPO 的 loss 跟它长得极像,这不是巧合。
1.3 PPO 阶段要同时装四个模型
阶段三用强化学习。模型生成回答,奖励模型打分,用分数当奖励信号去更新模型。
麻烦在于显存里要同时驻留四个模型:
| 模型 | 作用 | 要训吗 |
|---|---|---|
| policy | 正在训练的模型 | 要 |
| ref | SFT 后的模型,冻结,用来算 KL 约束 | 不 |
| reward | 打分 | 不 |
| critic | 估计状态价值,给 PPO 算优势函数 | 要 |
三条路线各要驻留几个模型,是它们工程复杂度的核心差异:
00-pretrain-0.5b/align_math.py 算出来的账:
路线                    模型数      字节/参数        显存
PPO(经典 RLHF)            4         36   18.08 GB
GRPO                    3         20   10.04 GB
DPO                     2         18    9.04 GB
PPO 要 18.08 GB,是 DPO 的两倍。而且 PPO 训练过程中要不断采样生成,超参多、调起来不稳,工程复杂度远高于另外两条路。
1.4 KL 惩罚在防什么
PPO 的目标函数里有一项 KL 惩罚,约束 policy 别离 ref 太远:
为什么需要它。因为奖励模型是个近似,它有漏洞。如果放任模型只管把分数刷高,它会找到奖励模型的破绽,生成一些分数极高但人看了莫名其妙的东西。这叫奖励攻陷(reward hacking)。
KL 惩罚就是拴住模型的绳子:可以变好,但别变得面目全非。
这一项在 DPO 里也在,只是形式变了,2.2 节会看到。
二、DPO:把 RL 消掉
2.1 核心洞察
DPO 那篇论文(Rafailov et al., 2023)的关键发现是:1.4 节那个「带 KL 约束的奖励最大化」问题,有闭式解。
解出来长这样:
意思是最优策略等于参考模型乘一个跟奖励有关的指数项。 是归一化因子。
这个式子本身没法直接用,因为 要对所有可能的回答求和,算不出来。
但可以把它反过来解出 :
这一步是整个 DPO 的转折点。它说明:奖励函数可以用策略模型自己表示出来,不需要单独训一个奖励模型。
2.2 怎么消掉的
上面那个式子还带着算不出来的 。但注意 1.2 节奖励模型的 loss 里, 只以差值的形式出现:。
两个回答对应同一个问题 ,所以它们的 完全相同,一减就没了:
代回 1.2 节那个 loss,就得到 DPO 的目标:
没有奖励模型,没有 critic,没有采样,没有 RL。 就是一个可以直接反向传播的监督损失。
这就是 DPO 这个名字的由来:Direct Preference Optimization,直接用偏好优化,中间不绕奖励模型。
2.3 每一项在做什么
把式子拆开看:
每一项是「当前模型给这个回答的概率,相对参考模型涨了还是跌了」。涨了就是正奖励,跌了就是负奖励。
优化目标是让 尽量大,也就是:对 chosen 的概率要相对涨,对 rejected 的概率要相对跌。
注意这里是相对参考模型。KL 约束就藏在这个比值里:模型不能无节制地改变概率分布,因为分母那个 一直在盯着。1.4 节那根绳子还在,只是换了个形式。
这四项在一次训练步里是怎么被算出来的,TRL 官方画了一张:
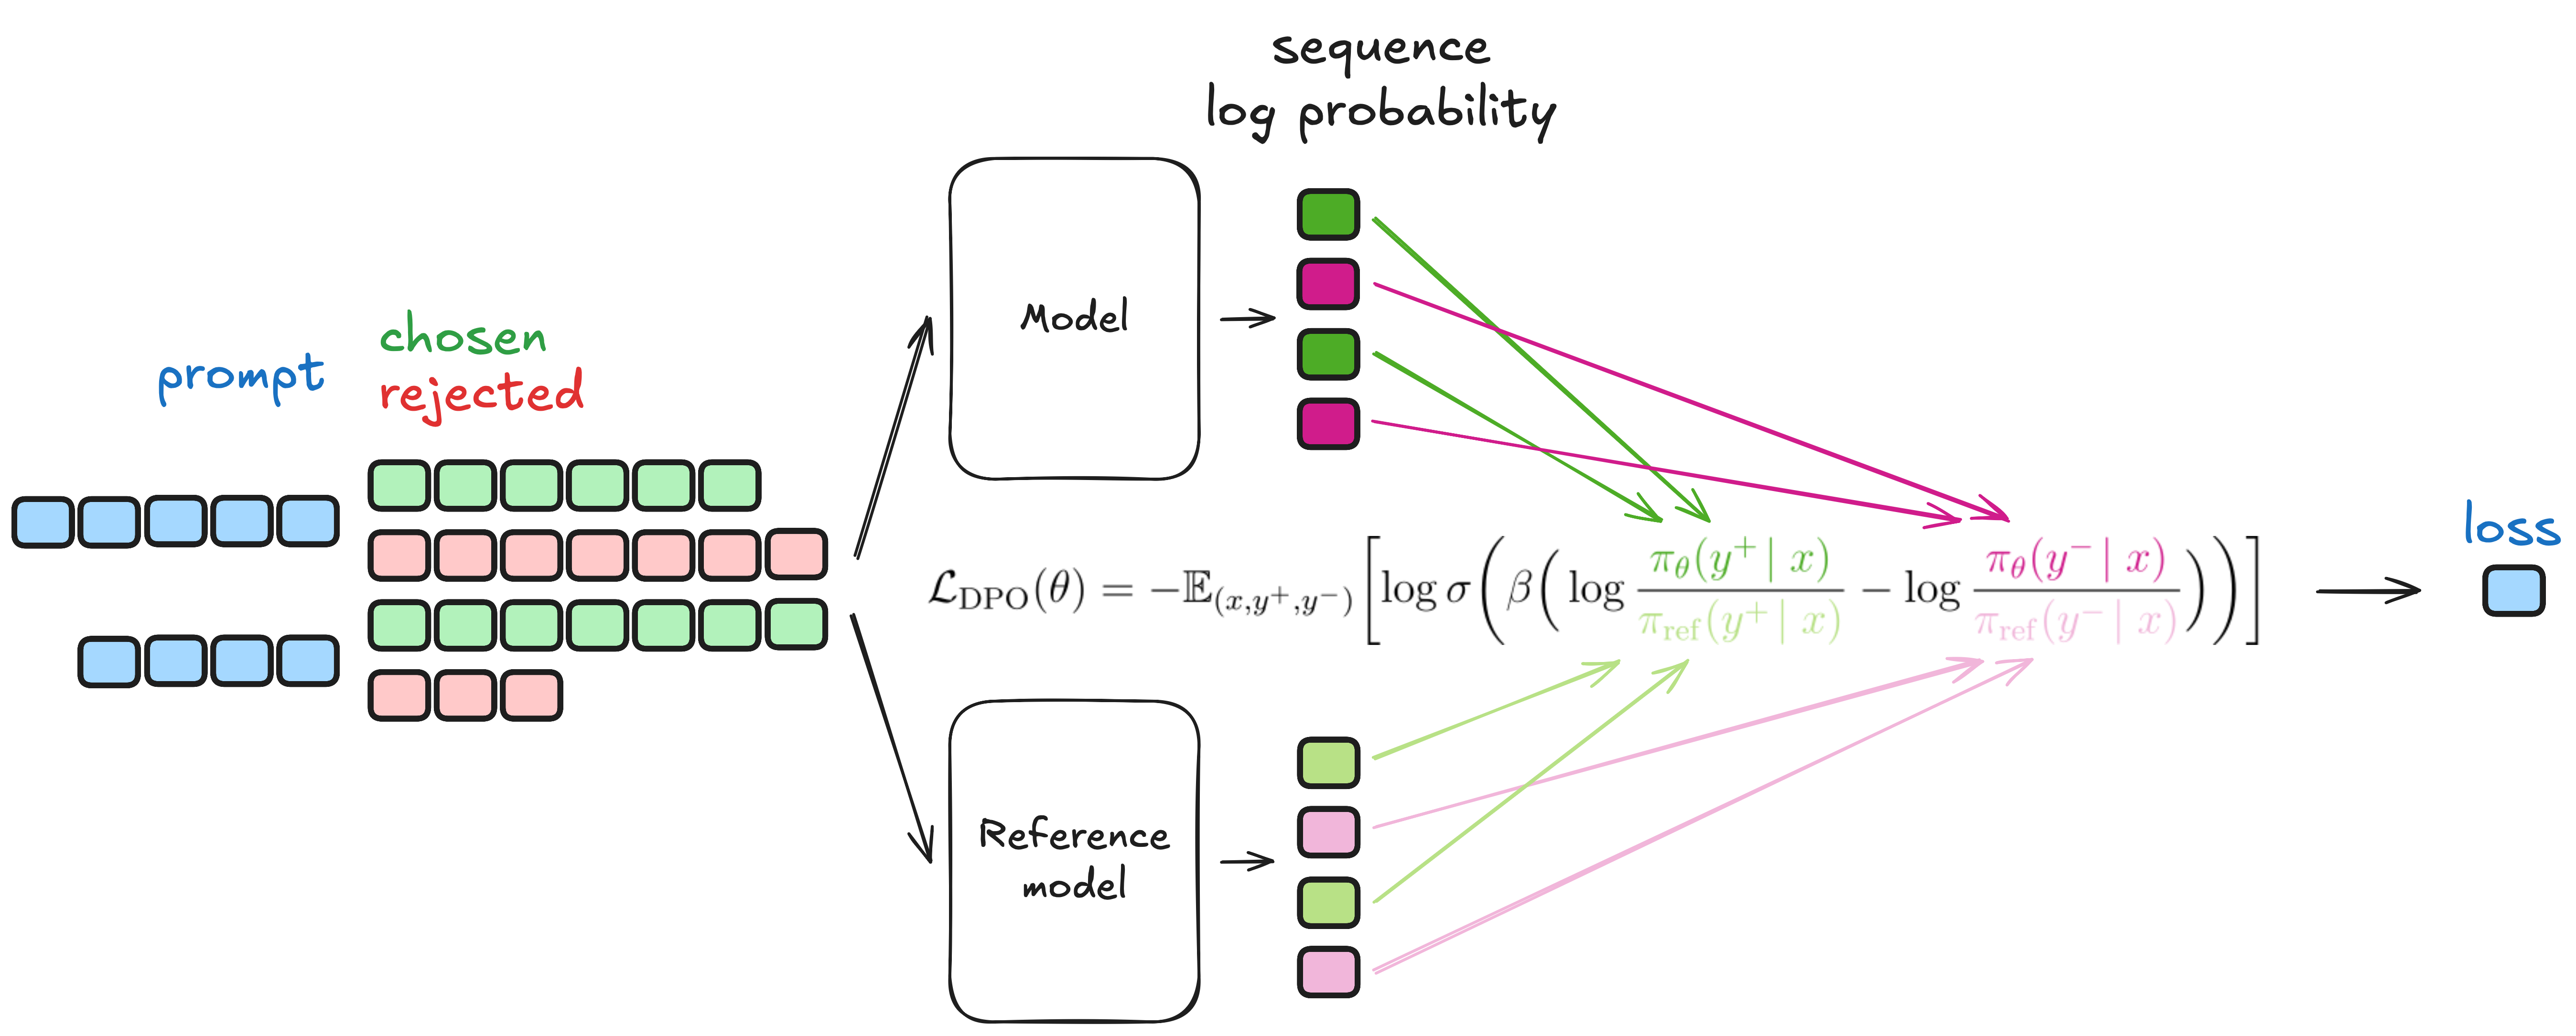
dpo_figure.png,Apache-2.0。图里值得留意的是左边那堆方块:prompt 和两条回答是拼成同一条序列送进去的,chosen 与 rejected 各走一遍,两个模型各走一遍,照图直写就是一步四次前向。3.3 节把 chosen 和 rejected 拼进同一个 batch,上面那条通路的两次并成一次;3.4 节把下面那条 ref 通路整个挪到训练前算好,四次于是只剩一次。reward_chosen 为负也完全正常。2.4 beta 的作用
控制约束的松紧:
| beta | 效果 |
|---|---|
| 小(0.01 到 0.05) | 约束松,模型敢大幅偏离 SFT,可能学得快但也容易跑偏 |
| 0.1 | 通行默认值 |
| 大(0.5 以上) | 约束紧,几乎不动,训了跟没训一样 |
从 0.1 开始试,基本不会错。
三、代码
3.1 算序列的对数概率
DPO 的 loss 需要「模型给某个回答的对数概率」,也就是回答里每个 token 的 log-prob 求和:
def sequence_logp(model, input_ids, labels):
    logits, _ = model(input_ids)
    logits = logits[:, :-1, :]                 # 错位一格,同 SFT
    labels = labels[:, 1:]

    mask = labels != IGNORE
    safe = labels.masked_fill(~mask, 0)        # gather 不接受负索引,先填 0

    logprobs = F.log_softmax(logits.float(), dim=-1)
    token_logp = torch.gather(logprobs, dim=2, index=safe.unsqueeze(2)).squeeze(2)
    return (token_logp * mask).sum(dim=-1)     # 被 mask 的位置贡献 0
三个细节:
labels 的构造复用 06 篇的 ChatTemplate,prompt 部分是 IGNORE,只在回答上算。这跟 SFT 是一致的,DPO 关心的也只是回答部分的概率。
masked_fill(~mask, 0) 那行是必须的。 IGNORE 是 -100,而 torch.gather 不接受负索引,会直接报错。先替换成 0,这些位置随后乘 mask 时会归零,不影响结果。
log_softmax 前转 fp32。 概率连乘在对数空间是求和,序列几百个 token 加下来,bf16 的精度不够,会累积明显误差。
3.2 loss
def dpo_loss(policy_logp, ref_logp, beta):
    b = policy_logp.shape[0] // 2
    pi_c, pi_r = policy_logp[:b], policy_logp[b:]
    ref_c, ref_r = ref_logp[:b], ref_logp[b:]

    reward_c = pi_c - ref_c          # 就是 2.3 节的隐式奖励
    reward_r = pi_r - ref_r
    logits = beta * (reward_c - reward_r)

    loss = -F.logsigmoid(logits).mean()
    ...
对着 2.2 节那个公式看,一一对应:pi_c - ref_c 就是 (对数相减等于比值取对数)。
用 F.logsigmoid 而不是 torch.log(torch.sigmoid(x)),前者数值稳定,后者在 x 很负时会算出 -inf。
3.3 一次前向拿到两边
chosen 和 rejected 拼进同一个 batch,前一半 chosen、后一半 rejected,一次前向搞定:
def collate(batch, pad_id):
    seqs = [s for pair in batch for s in pair]
    chosen, rejected = seqs[0::2], seqs[1::2]
    ordered = chosen + rejected            # 前一半 chosen,后一半 rejected
    ...
所以 dpo_loss 里用 policy_logp[:b] 和 [b:] 就能切开。
3.4 ref 模型怎么省
align_math.py 最后那段提到一个优化:
DPO 的 ref 前向可以预计算:偏好数据是固定的,
ref 模型也是冻结的,所以 ref 的两个 logp 可以离线算好存起来,
训练时就不用把 ref 模型放显存里了,降到 8.04 GB。
思路是:ref_logp 只依赖数据和冻结的 ref 模型,训练过程中永远不变。那就没必要每步重算,更没必要把 ref 模型一直放在显存里。
做法是训练前跑一遍全量数据,把每条样本的两个 ref_logp 算好存进文件,训练时直接读。省 1 GB 显存,还省掉一半前向计算。
trl 库里这个功能叫 precompute_ref_log_probs。数据量大的时候值得开。
四、超参
| 超参 | SFT | DPO | 为什么 |
|---|---|---|---|
| 学习率 | 2e-5 | 5e-7 | 又小两个数量级 |
| epoch | 2 到 3 | 1 | 极容易过拟合 |
| beta | — | 0.1 | 见 2.4 节 |
| batch size | 16 | 4 | 一条样本要跑两个序列 |
学习率是这一篇最要紧的超参。 DPO 对学习率极其敏感,5e-7 这个量级看着离谱,但确实是通行值。大了会直接把 SFT 学到的能力冲垮,表现是模型开始输出乱码或者疯狂重复。
epoch 就跑 1 轮。 DPO 过拟合非常快,第二轮往往就开始退化。
五、GRPO:为什么又转回 RL
5.1 DPO 的局限
DPO 简单好用,但有几个绕不过去的限制。
它是离线的。 偏好数据是事先标好的,里面的回答不是当前模型生成的。训着训着模型就偏离了数据的分布,这些数据对它的指导意义在下降。
它只能处理成对比较。 有些任务的好坏是可以直接判定的,比如数学题答案对不对、代码能不能跑通。这种情况下有明确的奖励信号,硬要构造成偏好对反而丢失信息。
它没法从探索中学习。 模型只能在给定的两个回答里学,没机会自己生成一堆再从中发现更好的。
对于推理类任务(数学、代码),这几点都是硬伤。所以又转回了 RL。
5.2 GRPO 的想法
GRPO(Group Relative Policy Optimization)要解决的是 PPO 最重的那个部件:critic。
回顾 1.3 节,PPO 的 critic 跟 policy 一样大、一样要训,占了显存的一半。它的作用是估计「基线」——判断当前这个回答比平均水平好多少。
GRPO 的做法很直接:既然要基线,那就对同一个问题生成一组(G 个)回答,用这组的平均分当基线。 不需要 critic 了。
优势函数变成组内的相对好坏:
比平均分高的回答,梯度推着模型多产出这种;低的,推着少产出。
5.3 三条路线对比
路线                    模型数      字节/参数        显存
PPO(经典 RLHF)            4         36   18.08 GB
GRPO                    3         20   10.04 GB
DPO                     2         18    9.04 GB
显存上 GRPO 比 PPO 省了 8 GB,就是省掉的 critic。
但要注意显存不是全部。GRPO 每条样本要生成 G 个回答(通常 8 到 16 个),生成本身很慢。所以 GRPO 的实际训练时间远长于 DPO,尽管显存只多 1 GB。
| DPO | GRPO | PPO | |
|---|---|---|---|
| 要奖励模型吗 | 不要 | 要(或用规则判定) | 要 |
| 要 critic 吗 | 不要 | 不要 | 要 |
| 在线采样 | 不用 | 要,每条生成 G 个 | 要 |
| 显存 | 9.04 GB | 10.04 GB | 18.08 GB |
| 训练速度 | 快 | 慢(要生成) | 最慢 |
| 适合什么 | 通用对话偏好 | 数学、代码这类有明确对错的 | 通用,但工程复杂 |
5.4 这个专题选 DPO
理由:0.5B 的模型做不了复杂推理,GRPO 那套「生成一组再挑」的优势体现不出来;而 DPO 单卡就能跑,一两个小时出结果,适合把流程走通。
想试 GRPO 的话,trl 和 verl 都有现成实现,00 篇参考资料里列了。
六、数据从哪来
2026-08-19 用 HuggingFace API 实测:
| 数据集 | 行数 | 体积 | 许可 | 说明 |
|---|---|---|---|---|
HuggingFaceH4/ultrafeedback_binarized | 187,405 | 650.0 MB | MIT | 最常用的通用偏好数据 |
Anthropic/hh-rlhf | 169,352 | — | MIT | 经典的有用性和无害性偏好 |
nvidia/HelpSteer2 | 21,362 | 11.9 MB | CC-BY-4.0 | 多维度评分,质量高 |
llamafactory/DPO-En-Zh-20k | 19,997 | 79.9 MB | Apache-2.0 | 中英双语,适合我们 |
argilla/dpo-mix-7k | 7,500 | 24.2 MB | MIT | 小而精,快速验证用 |
建议先用 argilla/dpo-mix-7k 把流程跑通(7500 条,很快),再换 llamafactory/DPO-En-Zh-20k 正式训。
七、训练时盯什么
DPO 的 loss 数值本身不太直观,真正要看的是这几个指标,dpo_loss 里都返回了:
| 指标 | 健康的样子 | 不对劲说明什么 |
|---|---|---|
acc | 从 0.5 涨到 0.7 以上 | 一直在 0.5 说明完全没学到 |
reward_margin | 稳定上升 | 不涨说明学习率太小或数据有问题 |
reward_chosen | 小幅波动,可正可负 | 暴跌说明模型在崩 |
reward_rejected | 应该下降 | 上升说明方向反了 |
acc 是最直观的:模型给 chosen 的隐式奖励高于 rejected 的比例。训练开始时应该在 0.5 附近(随机),然后往上走。
一个容易误判为故障的现象:reward_chosen 经常为负且持续下降。这是正常的。DPO 优化的是两者的差值,只要 reward_rejected 跌得更快,差值就在扩大,目标就在达成。看 margin 和 acc,别盯着 reward_chosen 的绝对值。
八、验收
- 数据里 chosen 和 rejected 的 prompt 部分确认完全一致
-
sequence_logp只在回答部分累加,prompt 部分是 IGNORE - 初始
acc在 0.5 附近 - 训练过程中
acc涨到 0.65 以上 -
reward_margin稳定上升 - 训完模型仍然会正常对话,没有退化成乱码或复读
- 拿几个问题对比 SFT 模型和 DPO 模型的输出,能看出差别
最后一条是真正的验收。如果 DPO 前后输出看不出任何差别,说明 beta 太大或者学习率太小,等于没训。 反过来如果模型开始胡言乱语,是学习率太大。
九、常见问题
| 现象 | 大概率是什么原因 |
|---|---|
torch.gather 报索引越界 | IGNORE 是 -100,没转成 0,见 3.1 节 |
| 训完输出乱码或疯狂重复 | 学习率太大,DPO 要 5e-7 量级 |
| 训完跟没训一样 | beta 太大,或者学习率太小 |
acc 一直在 0.5 | chosen 和 rejected 拼接顺序错了,检查 collate |
reward_chosen 一直跌 | 正常现象,看 margin 和 acc,见第七节 |
| loss 降但模型变差 | 过拟合,epoch 减到 1 |
| 显存不够 | 开 precompute_ref_log_probs,省掉 ref 模型 |
| logp 数值明显不对 | log_softmax 前没转 fp32 |
DPO 的收益是有限的
0.5B 模型做完 DPO,能看到的改善主要是回答更完整、格式更规整。别期待它变得会推理——那是模型规模和预训练数据决定的。这一篇的价值在于把偏好对齐这条链路走通,而不是把模型救成一个好用的助手。